2017年6月、AIの歴史を大きく変えることになる一本の論文が発表されました。
Attention Is All You Need
直訳すれば、「Attentionこそが必要な全てである」。
この論文で提案されたのが、現在では生成AIを理解するうえで避けて通れない「Transformer」というニューラルネットワークのアーキテクチャです。
Transformer以前、文章は「順番に」読んでいた
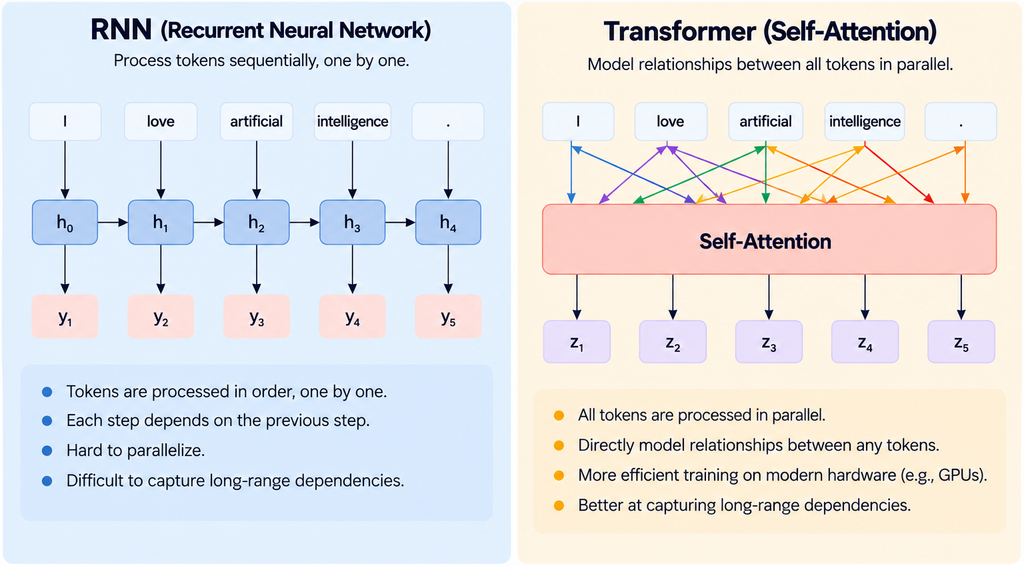
まず、この論文が何を変えたのかを理解するために、当時主流だったRNN(Recurrent Neural Network)について簡単に見てみましょう。
例えば、次の英文を処理するとします。
I love artificial intelligence.
RNNは基本的に、
I → love → artificial → intelligence
という順番で単語を処理していきます。
「love」を処理するときには「I」までの情報を使い、「artificial」を処理するときには、それまでに処理してきた情報を使う、といった具合です。人間が文章を左から右へ読む感覚にも似ており、自然な方法に見えます。
しかし、前の処理が終わらなければ、次の処理を始められない。つまり、「I」の処理を終えてから「love」を処理し、「love」を終えてから「artificial」を処理する必要があります。
GPUは大量の計算を同時並行で処理することを得意とします。しかし、このように計算が順番に依存していると、その能力を十分に生かすことができません。
さらに、離れた位置にある単語同士の関係を捉える場合にも、情報が多くのステップを経由しなければならないという問題がありました。長い文章になるほど、遠く離れた情報を結びつけることが難しくなるわけです。
Attentionは、Transformer以前から存在していた
ここで登場するのが「Attention」です。ただし、『Attention Is All You Need』がAttentionそのものを発明したわけではありません。Attentionは、それ以前からニューラル機械翻訳などで利用されていました。
2014年に発表されたBahdanauらの論文では、翻訳文を生成するときに、入力文のどの部分を見るべきかをモデル自身に判断させるAttentionの仕組みが提案されています。
例えば、ある英単語を日本語へ訳そうとしているとき、入力された英文のすべての単語を同じように扱う必要はなく、今まさに訳そうとしている単語と関係の深い部分に強く「注目」すればよい。これがAttentionの基本的な考え方です。
ただし当時のAttentionは、RNNなどと組み合わせて使われるのが一般的でした。文章を処理する中心には依然としてRNNがあり、Attentionはその処理を助ける仕組みだったのです。
「それなら、RNNそのものをなくしてしまえないだろうか?」
『Attention Is All You Need』の大胆さは、ここにあります。著者たちは、RNNだけでなくCNNも使わず、Attentionを中心に文章を処理する新しいアーキテクチャを構築しました。
それが、Transformerです。
Self-Attentionという、単語同士を直接結びつける仕組み
Transformerの中心にあるのがSelf-Attentionです。
Self-Attentionとは、簡単にいえば、一つの文章の中にある単語同士の関係を調べる仕組みです。
例えば、次のような文があるとします。
The cat didn’t cross the street because it was tired.
「it」という単語だけを見ても、それが何を指しているのかはわかりません。しかし文章全体を見れば、「cat」と強い関係があることがわかります。
Self-Attentionでは、それぞれの単語が文章中のほかの単語とどれくらい関係しているのかを計算し、その重要度に応じて情報を取り込みます。つまり、「今この単語を理解するためには、文章のどこを見るべきか」をモデル自身が学習するわけです。
しかも、RNNのように、遠く離れた単語まで情報を一つずつ伝えていく必要はありません。文章の最初にある単語と最後にある単語であっても、Self-Attentionでは直接関係を計算できます。
Query・Key・Valueとは何か
論文では、AttentionをQuery(Q)、Key(K)、Value(V)という3つの要素を使って計算します。
この言葉が出てくると急に難しく感じますが、基本的な発想だけならそれほど複雑ではありません。
- Query:私はどんな情報を探しているのか
- Key:私はどんな情報を持っているのか
- Value:実際に渡す情報
と考えるとイメージしやすくなります。
ある単語のQueryと、文章中にある各単語のKeyを比較します。QueryとKeyの相性がよければ、その単語は重要だと判断され、そのValueを強く取り込みます。逆に関係が弱ければ、そのValueはあまり取り込みません。
実際にはベクトル同士の内積やSoftmaxなどを使って計算されますが、考え方としては、「今必要としている情報」と「それぞれの単語が持つ情報」を照合し、重要な情報を集めるという仕組みだと考えればよいでしょう。
複数の見方を同時に使うMulti-Head Attention
Transformerでは、このAttentionを一度だけ行うのではありません。Multi-Head Attentionと呼ばれる仕組みを使います。
「Head」とは、簡単にいえば一つのAttentionです。Multi-Head Attentionではその名の通り、一つだけではなく、複数のAttentionを並行して動かします。
その理由は、文章の中には、一種類だけではない多様な関係が存在するからです。例えば、あるAttentionは近くの単語との関係に注目し、別のAttentionは離れた単語との関係に注目するかもしれません。また、あるAttentionは文法的な関係を捉え、別のAttentionは意味的な関係を捉えるかもしれません。
論文のTransformerでは、基本モデルで8個のAttention Headを並行して使用しました。著者たちは、複数のHeadを使うことで、モデルが異なる位置にある、異なる種類の情報へ同時にAttentionを向けられると説明しています。
Positional Encodingの意義
RNNをなくしたことで、一つ新しい問題が生まれます。
単語の順番をどうやって理解するのか。
RNNでは、「1番目の単語を処理してから2番目へ進む」という構造そのものが、単語の順序を持っています。
しかしSelf-Attentionでは、文章中の各位置を直接結びつけます。
そのままでは、
犬が人を噛んだ
人が犬を噛んだ
という二つの文について、「犬」「人」「噛む」という要素はわかっても、その順番を十分に区別できません。
そこでTransformerでは、単語そのものを表す情報に、その単語が文章の何番目にあるのかを表す情報を加えます。これがPositional Encoding(位置エンコーディング)です。
元論文では、異なる周期を持つsinとcosの波を利用して位置情報を表現していますが、重要なのは、「Attentionだけでは失われてしまう語順の情報を、別の方法でモデルに与えた」ということです。
Transformerは、文章を一気に処理できる
では、なぜここまでしてRNNをなくす必要があったのでしょうか。
大きな理由の一つが、並列計算です。
RNNでは、文章を順番に処理する必要がありました。一方、Self-Attentionでは、文章中の多数の位置についてAttentionの計算をまとめて行うことができます。そのため、GPUによる並列計算との相性がよく、学習を効率化できます。
論文はSelf-Attentionを採用する理由として、計算量だけでなく、並列化のしやすさと離れた位置同士を結ぶ経路の短さを比較しています。
RNNでは、文章中で遠く離れた二つの単語を結びつけるために、多数の処理ステップを経由しなければなりません。Self-Attentionなら、どれだけ離れていても直接関係を計算できます。
つまりTransformerは、「文章を順番にたどる」のではなく、「文章中の要素同士の関係を直接計算する」方向へ発想を切り替えたモデルだと見ることができます。
性能と学習コストの両方で優れた結果を見せた
新しい仕組みを提案するだけでは十分ではありません。本当に性能が高いのかを示す必要があります。そこで著者たちは、Transformerを、WMT 2014の英語→ドイツ語、英語→フランス語の機械翻訳タスクで評価しました。
その結果、英語からドイツ語の翻訳では、大型のTransformerが28.4 BLEUを達成しました。これは当時報告されていた既存モデルを、アンサンブルを含めて2 BLEU以上上回る結果でした。
しかも、性能だけではなく、学習コストを大幅に抑えられたことも強調されています
ただし、Self-Attentionがあらゆる面で優れているわけではありません。通常のSelf-Attentionでは、文章中の各位置とほかの各位置との関係を計算します。
この時、文章が2倍の長さになると、比較しなければならない組み合わせは単純に2倍ではなく、大まかには4倍になります。つまり、文章が長くなるほどAttentionの計算量とメモリ使用量が急速に増えていくという問題があります。
この論文自身も、非常に長い系列を扱う場合にはSelf-Attentionを周辺の一定範囲だけに制限する方法などを将来の課題として挙げています。後のTransformer研究では、この問題を改善するさまざまなAttention手法が研究されることになります。
まとめ
『Attention Is All You Need』を一言でまとめるなら、「文章は、必ずしも順番に処理しなくてもよい」と示した論文だといえます。
当時、文章を扱うニューラルネットワークでは、RNNやLSTMが中心的な役割を果たしており、Attentionを補助的に追加する、というのが有力な方法でした。
Transformerは、その関係を逆転させ、Attentionを補助役として使うのではなく、Attentionを中心にモデルそのものを構築したのです。
その結果、文章中で離れた位置にある情報を直接結びつけることができ、さらに学習時の計算を大幅に並列化できるようになりました。そして、その新しい設計は機械翻訳でも当時最高水準の性能を示しました。
現在の大規模言語モデルは、必ずしもこの論文とまったく同じTransformerの構成を使っているわけではありません。それでも、Self-Attention、Multi-Head Attention、Positional EncodingといったTransformerの基本的な考え方は、その後の大規模言語モデルへ受け継がれていきました。
参考文献
Ashish Vaswani et al., Attention Is All You Need, 2017.
https://arxiv.org/abs/1706.03762